AI 코딩 벤치마크 순위는 참고까지만 믿는 것이 맞습니다. 가장 많이 인용되는 SWE-bench는 실제 깃허브 이슈를 AI가 고치는지 재는 시험이라 의미가 있지만, 같은 표 안에서도 비교 조건이 다르고, 시험 문제가 AI 학습 자료에 섞였다는 공식 분석도 나왔습니다.
OpenAI는 2026년 2월 23일 SWE-bench Verified 점수 보고를 멈췄다고 밝혔습니다. 2026년 10월 22일 SWE-bench 공식 사이트·논문과 OpenAI 공식 글을 직접 읽고, 순위를 볼 때 무엇을 확인해야 하는지 정리했습니다.
1. AI 코딩 벤치마크 순위, 믿어도 될까?
참고까지만입니다. 벤치마크는 정해진 문제를 똑같이 풀게 해 점수를 매기는 성능 시험입니다. 점수가 높다는 것은 그 시험 문제를 잘 풀었다는 뜻이지, 내 가게 홈페이지나 업무 앱을 잘 만든다는 보장은 아닙니다.
순위표를 읽을 때 걸리는 점은 세 가지입니다. 어떤 문제 묶음으로 쟀는지, 같은 조건에서 쟀는지, 시험 문제를 AI가 미리 봤을 가능성이 있는지입니다. 아래에서 공식 문서가 직접 밝힌 내용으로 하나씩 봅니다.
2. SWE-bench는 실제 깃허브 이슈를 고치게 하는 시험입니다
SWE-bench는 개발자들이 깃허브(코드를 함께 관리하는 사이트)에 올린 실제 문제 신고 글, 곧 이슈를 모아 만든 시험입니다. 공식 문서는 코드 묶음과 이슈를 주고, AI가 그 문제를 해결하는 코드 수정본(패치)을 만들게 한다고 설명합니다.
2023년 처음 공개된 논문 기준 원본은 인기 있는 파이썬 저장소 12곳에서 가져온 문제 2,294개입니다. 그때 가장 잘한 모델도 원본 문제의 1.96%만 풀었다고 논문에 적혀 있습니다.
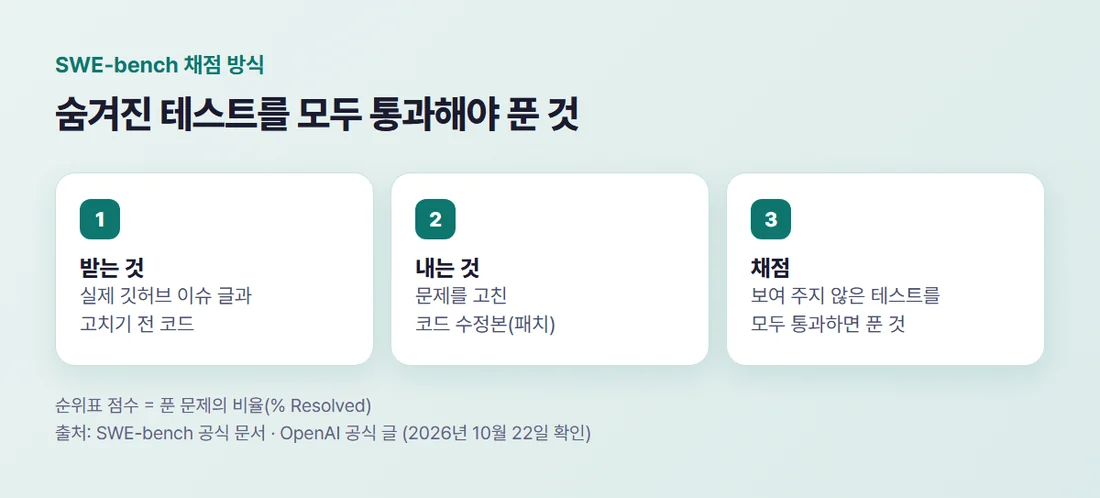
채점은 테스트로 합니다. OpenAI 공식 글에 따르면 AI에게는 테스트 코드를 보여 주지 않고, 수정본을 적용한 뒤 모든 테스트를 통과해야 그 문제를 푼 것으로 칩니다. 순위표 점수는 이렇게 푼 문제의 비율(% Resolved)입니다.
3. Verified·Lite 등 갈래마다 문제 수가 다릅니다
SWE-bench 공식 사이트에는 여러 갈래의 순위표가 따로 있습니다. 같은 「SWE-bench 점수」라도 어느 갈래인지에 따라 푼 문제 묶음이 다릅니다.
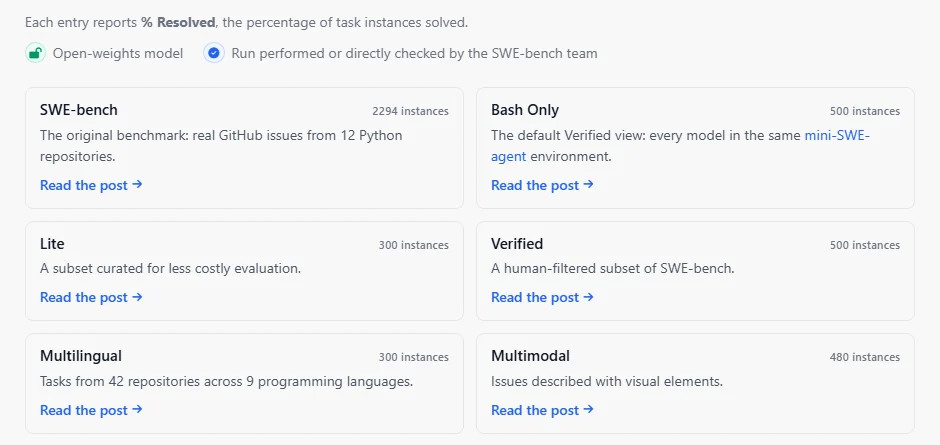
- Verified: 원본에서 사람이 걸러 낸 500개. OpenAI와 함께 만들었고, 문제 설명이 분명하고 풀 수 있는지 사람이 검토했습니다
- Lite: 평가 비용을 줄이려고 고른 300개. 파일 2개 이상을 고치는 문제는 뺐습니다
- Multilingual: 9개 프로그래밍 언어, 42개 저장소에서 가져온 300개
- Multimodal: 화면 그림이 함께 붙은 이슈 480개
그래서 두 도구의 점수를 비교할 때는 먼저 같은 갈래의 점수인지 확인해야 합니다. Lite 점수와 Verified 점수는 서로 다른 시험의 점수입니다.
4. 같은 순위표 안에서도 비교 조건이 다릅니다
Verified 순위표에는 단순한 AI 반복 실행부터 여러 번 시도하고 검토하는 시스템까지 다양한 코딩 시스템의 결과가 섞여 있다고 공식 페이지가 밝힙니다. 모델 자체보다 그 모델을 둘러싼 도구의 차이가 점수에 들어갈 수 있다는 뜻입니다.
그래서 SWE-bench 팀은 모든 모델을 같은 최소 환경(mini-SWE-agent)에서 돌린 Bash Only 보기를 따로 둡니다. 공식 사이트는 이것을 Verified의 기본 보기로 소개합니다.
이 Bash Only 안에서도 실행 도구의 1.x판과 2.x판 결과는 꼭 비교할 수 있는 것이 아니라고 공식 페이지에 적혀 있습니다. 순위표에서 점수 옆의 버전 표시까지 같은지 봐야 하는 이유입니다.
5. OpenAI는 2026년 2월 Verified 점수 보고를 멈췄습니다
SWE-bench Verified를 함께 만든 OpenAI는 2026년 2월 23일 공식 글에서 Verified 점수 보고를 중단했다고 밝혔습니다. 이유로 든 것은 두 가지입니다.
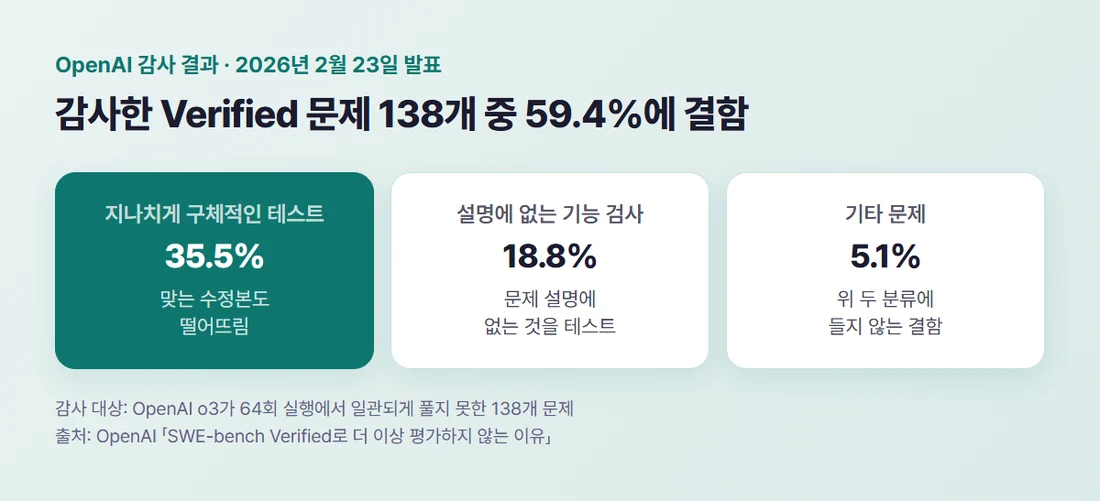
첫째는 테스트 결함입니다. OpenAI가 모델이 계속 풀지 못한 문제 138개를 감사해 보니, 그중 59.4%에 테스트 설계나 문제 설명의 중대한 결함이 있었습니다. 맞는 수정본도 떨어뜨리는 테스트가 있었다는 것입니다.
둘째는 오염입니다. 시험 문제가 공개 저장소에서 나오다 보니, 테스트한 모든 최신 모델이 정답 수정본을 재현하거나 문제 설명의 세부를 글자 그대로 재현할 수 있었다고 합니다. OpenAI는 그 결과를 이렇게 정리했습니다.
이는 SWE-bench Verified 점수의 향상이 모델의 실제 소프트웨어 개발 능력에 있어 유의미한 향상을 더 이상 반영하지 않음을 의미합니다.
OpenAI는 오염되지 않은 새 평가를 만드는 중이며, 그때까지는 SWE-bench Pro 결과를 보고할 것을 권한다고 밝혔습니다. 다만 이것은 지금 수준의 최신 모델을 가르는 데 Verified가 맞지 않다는 OpenAI의 판단이고, SWE-bench 공식 사이트에는 Verified 순위표가 계속 올라와 있습니다.
6. 순위표 대신 내 일로 직접 시험해 봅니다
공식 문서들이 말하는 한계를 모으면, 순위표 점수는 「이 시험에서 이 조건으로 얼마나 풀었나」까지입니다. 내 일에 맞는지는 순위표가 알려 주지 않습니다.
도구를 고를 때는 무료로 쓸 수 있는 범위 안에서 내가 실제로 맡길 작은 일을 두세 도구에 똑같이 시켜 보는 편이 확실합니다. 문구 고치기나 작은 화면 하나처럼 결과를 눈으로 확인할 수 있는 일이 좋습니다.
정리하면 순위표를 볼 때 세 가지를 확인합니다.
- 같은 갈래(Verified·Lite 등)의 점수인가
- 같은 조건(Bash Only, 같은 버전)에서 잰 점수인가
- 문제 오염 같은 한계를 공식 쪽이 밝힌 시험인가
무료로 시험해 볼 수 있는 도구는 AI 코딩 툴 무료, 어디까지 쓸 수 있나?에 모았습니다. 코덱스 플랜별 차이는 코덱스 요금제 비교에, 제미나이 CLI 무료 사용이 어떻게 바뀌었는지는 제미나이 cli 요금에 정리했습니다.
참고자료 (모두 2026년 10월 22일 확인)
- SWE-bench 공식 사이트·순위표 — swebench.com
- SWE-bench 공식 문서 「Overview」 — swebench.com/SWE-bench
- SWE-bench Verified·Lite 안내 — swebench.com/verified.html · swebench.com/lite.html
- 논문 「SWE-bench: Can Language Models Resolve Real-World GitHub Issues?」 — arxiv.org/abs/2310.06770
- OpenAI 「SWE-bench Verified로 더 이상 평가하지 않는 이유」 — openai.com
#AI코딩 #코딩벤치마크 #SWEbench #AI코딩툴 #바이브코딩