네이버 서치어드바이저 가이드 기준으로 robots.txt는 사이트의 루트 디렉터리(맨 위 폴더)에 일반 텍스트 파일로 올려 두면 됩니다. 네이버 검색로봇은 그 안의 규칙을 지키고, 파일이 없으면 모든 콘텐츠를 수집할 수 있다고 봅니다.
robots.txt는 검색로봇에게 사이트와 웹페이지를 수집하도록 허용하거나 제한하는 국제 권고안입니다. 2026년 11월 5일 네이버 서치어드바이저 웹마스터 가이드와 표준 문서를 직접 읽고, 네이버 검색로봇 이름과 쓸 수 있는 예시 규칙을 정리했습니다.
1. 네이버 서치어드바이저 robots.txt는 어떻게 설정하나요?
사이트의 루트 디렉터리에 robots.txt 파일을 두고, 텍스트 파일(text/plain)로 접근할 수 있게 하면 됩니다. 예를 들어 사이트 주소가 www.example.com이면 파일 주소는 http://www.example.com/robots.txt 입니다.
robots.txt 파일은 항상 사이트의 루트 디렉터리에 위치해야 하며 로봇 배제 표준을 따르는 일반 텍스트 파일로 작성해야 합니다.
가이드는 IETF가 2022년 9월에 이 표준화 문서를 발행했다고 적었습니다. 표준은 RFC 9309(Robots Exclusion Protocol)입니다.
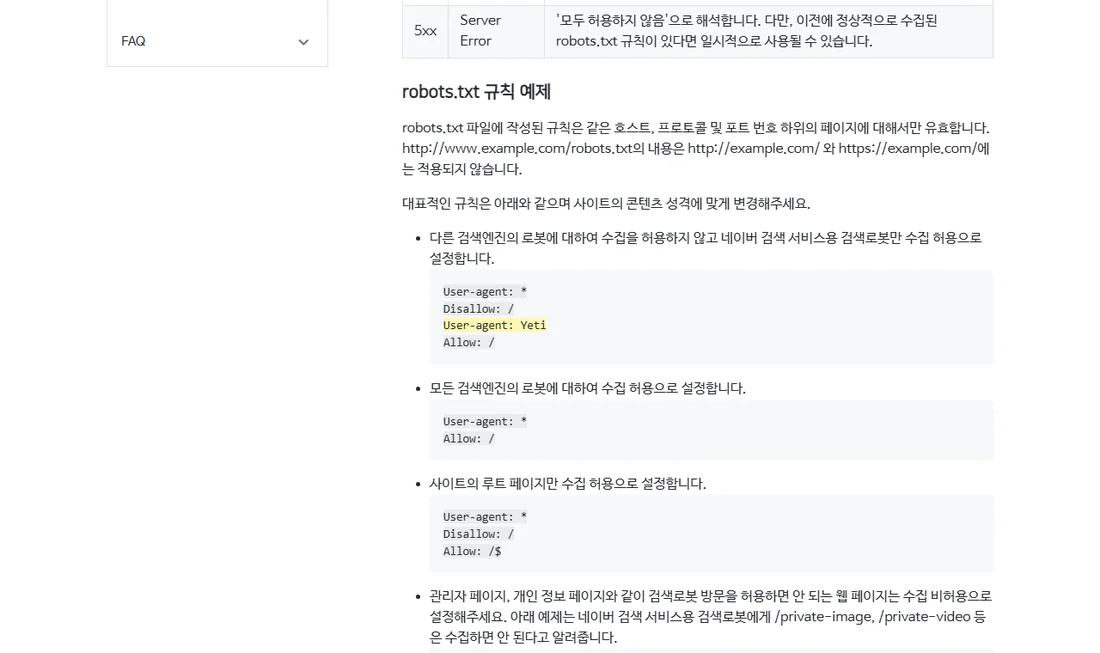
규칙은 같은 호스트·프로토콜·포트 아래 페이지에만 유효합니다. www.example.com의 robots.txt는 example.com이나 https 주소에는 적용되지 않는다고 가이드가 적었습니다.
2. 응답 코드에 따라 달라지는 해석
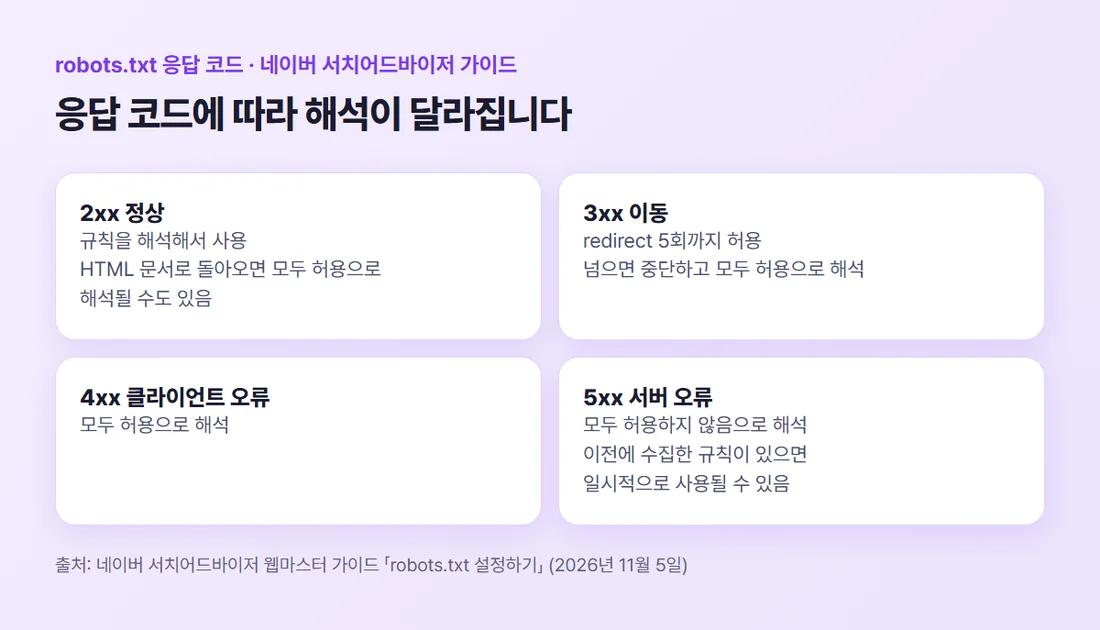
검색로봇이 robots.txt에 접근했을 때는 정상적인 2xx 응답 코드를 전달해 달라고 가이드는 안내합니다. 응답 코드별 해석은 가이드 표에 이렇게 적혀 있습니다.
- 2xx: 로봇 배제 표준을 지키는 규칙을 해석해 씁니다. robots.txt가 HTML 문서로 돌아오면 유효한 규칙이 있어도 없음(모두 허용)으로 해석될 수 있습니다
- 3xx: HTTP redirect를 5회까지 허용하고, 그 이상이면 중단한 뒤 모두 허용으로 해석합니다. HTML·자바스크립트 이동은 해석되지 않습니다
- 4xx: 모두 허용으로 해석합니다
- 5xx: 모두 허용하지 않음으로 해석합니다. 다만 이전에 정상 수집한 규칙이 있으면 일시적으로 쓰일 수 있습니다
3. 네이버 검색로봇 Yeti 허용·차단 예시
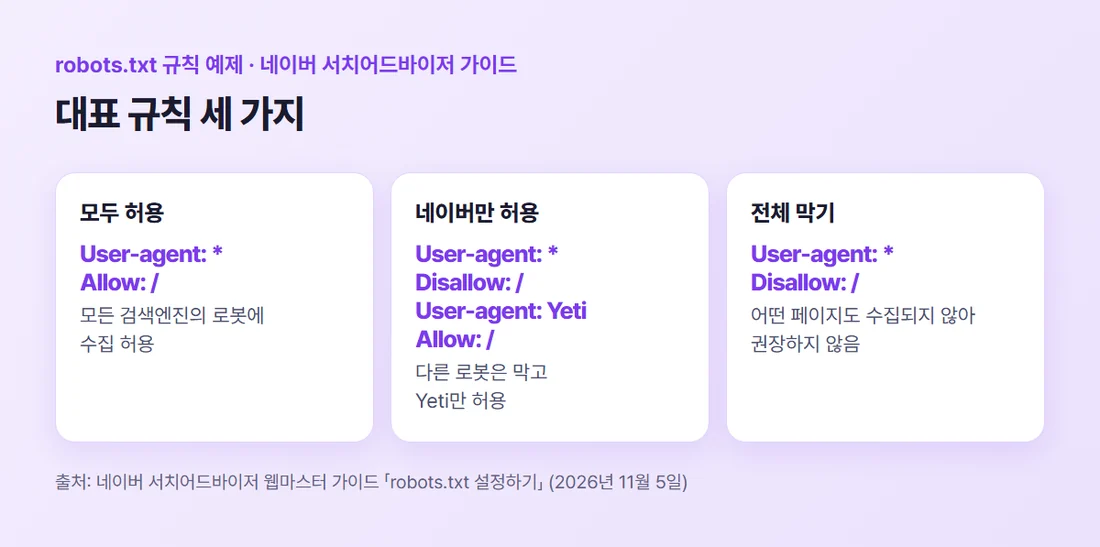
네이버 검색 서비스용 검색로봇의 이름은 Yeti입니다. robots.txt에서는 User-agent: Yeti 줄로 이 로봇만 가리킬 수 있습니다. 가이드의 대표 규칙 가운데 네 가지를 골라 그대로 옮깁니다.
모든 검색엔진의 로봇에 수집을 허용할 때는 User-agent: * 아래에 Allow: / 를 씁니다.
네이버 검색로봇만 수집을 허용하려면 모든 로봇을 막은 뒤 Yeti를 허용하는 두 묶음을 씁니다. 첫 묶음은 User-agent: * 와 Disallow: /, 두 번째 묶음은 User-agent: Yeti 와 Allow: / 입니다.
관리자 페이지나 개인 정보 페이지처럼 방문을 허용하면 안 되는 곳은 따로 막습니다. 가이드 예제는 User-agent: Yeti 아래 Disallow: /private*/ 로, 네이버 검색로봇에게 /private-image, /private-video 등을 수집하지 말라고 알립니다.
모든 검색로봇에게 사이트 전체의 수집을 막는 Disallow: / 는 어떤 페이지도 수집 대상에 포함되지 않으므로 권장하지 않는다고 가이드가 적었습니다.
4. 막지 말아야 할 것과 robots.txt로 지킬 수 없는 것
가이드는 파비콘(favicon, 브라우저 탭의 작은 아이콘) 수집을 허용해 달라고 부탁합니다. 검색로봇이 파비콘을 문서의 일부로 보기 때문에, 문서는 허용인데 파비콘 경로만 막으면 로봇이 예외적으로 규칙을 따르지 않고 수집을 시도할 수 있다고 설명합니다.
자바스크립트와 CSS 파일 경로도 같습니다. 현대적인 검색로봇은 이 리소스를 수집이 허용된 문서의 한 부분으로 보므로, 참조하는 문서와 같은 규칙을 쓰거나 기본적으로 수집을 허용해 달라고 가이드는 부탁합니다.
robots.txt를 보안 장치로 쓰면 안 된다는 점도 분명합니다. 가이드는 웹마스터와 별도의 수집 조건 협약이 있는 경우 광고주 정보 취득이나 링크 미리보기 생성 같은 특수한 용도의 로봇은 robots.txt를 따르지 않거나 완벽하게 따르지 않을 수 있다고 적었습니다.
개인정보처럼 밖에 드러나면 안 되는 콘텐츠는 robots.txt만 믿지 말고 로그인 기능 같은 다른 방법으로 지켜야 합니다.
표준 문서 RFC 9309도 영어 원문으로 「These rules are not a form of access authorization.」, 곧 이 규칙은 접근 권한을 주는 장치가 아니라고 적었습니다(우리말로 옮겼습니다).
5. sitemap.xml 알리기와 웹마스터도구의 robots.txt 도구
사이트 페이지 목록이 담긴 sitemap.xml의 위치를 robots.txt에 적어 두면 검색로봇이 콘텐츠를 더 잘 수집하도록 도울 수 있다고 가이드는 설명합니다. 예제는 Sitemap: http://www.example.com/sitemap.xml 줄입니다.
웹마스터도구에는 robots.txt 도구가 있습니다. 하나는 robots.txt 수집 및 검증입니다. 파일을 고친 뒤 「수집 요청」을 누르면 검색로봇에게 빠르게 알리고, 설정한 규칙대로 웹페이지 수집이 가능한지 시험해 볼 수 있습니다. 다른 하나는 robots.txt 간단 생성으로, 파일을 만들어 내려받을 수 있습니다.
수집 요청이 무엇을 해 주는지는 네이버 서치어드바이저 웹페이지 수집, 요청하는 법에 정리했습니다.
6. 검색로봇이 막히지 않았는지 확인하는 법
사이트가 검색에 나오지 않거나 정보가 바뀌지 않는다면, 방화벽이 User-Agent 이름이나 IP 주소 때문에 검색로봇을 막고 있지 않은지 점검해야 한다고 가이드는 안내합니다. 소유확인이 안 될 때도 같은 점검이 필요합니다.
네이버의 일반 검색용 로봇은 Yeti라는 이름이고, User-Agent에는 Mozilla/5.0 (compatible; Yeti/1.1; +https://naver.me/spd) 같은 문자열이 들어갑니다. 세부 버전은 사전 예고 없이 바뀔 수 있습니다.
IP로 확인하려면 접근한 IP를 역 DNS로 조회해 도메인이 naver.com으로 끝나는지 보고, 그 도메인을 다시 조회해 원래 IP와 같은지 확인합니다. 광고용(Ads-Naver)과 링크 미리보기용(Blueno) 같은 전문 로봇도 따로 있다고 가이드는 적었습니다.
정리하면 robots.txt 설정은 이렇게 합니다.
- 루트 디렉터리에 텍스트 파일(text/plain) robots.txt를 올리고, 2xx 응답이 가는지 확인합니다
- 모두 허용, 네이버만 허용, 일부 폴더만 막기 가운데 사이트에 맞는 규칙을 고릅니다
- 파비콘·자바스크립트·CSS 경로는 가이드가 수집을 허용해 달라고 부탁합니다
- 외부에 드러나면 안 되는 내용은 로그인 같은 다른 방법으로 지킵니다
- 웹마스터도구 robots.txt 도구로 검증하고, 고쳤다면 수집 요청을 누릅니다
소유확인에서 검색로봇 접근이 막혔다면 네이버 서치어드바이저 소유확인 안 될 때를, 전체 그림은 네이버 서치어드바이저란? 처음 쓰는 법 총정리를 보세요.
참고자료 (모두 2026년 11월 5일 확인)
- 네이버 서치어드바이저 웹마스터 가이드 「robots.txt 설정하기」 — searchadvisor.naver.com/guide/seo-basic-robots
- 네이버 서치어드바이저 웹마스터 가이드 「검색로봇 확인 방법」 — searchadvisor.naver.com/guide/seo-basic-firewall
- IETF RFC 9309 「Robots Exclusion Protocol」 — rfc-editor.org/rfc/rfc9309.html
#네이버서치어드바이저 #robotstxt설정 #네이버검색로봇 #Yeti #웹마스터도구