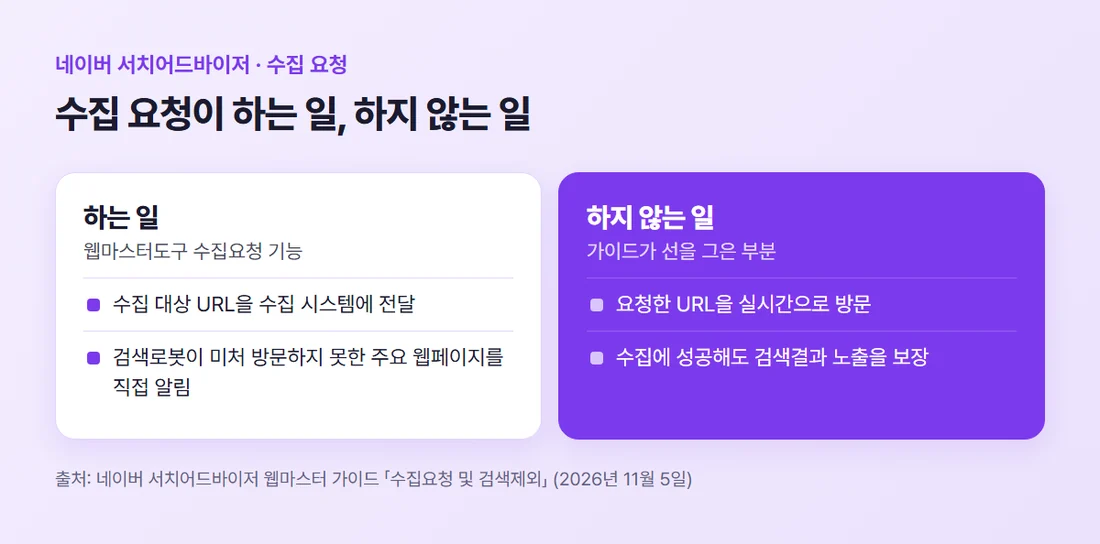
네이버 서치어드바이저의 웹페이지 수집 요청은 검색로봇이 미처 방문하지 못한 사이트의 주요 웹페이지를 사용자가 직접 수집해 달라고 알리는 기능입니다. 다만 요청한다고 검색로봇이 바로 찾아오지 않고, 수집에 성공해도 검색결과에 노출된다는 보장은 없습니다.
2026년 11월 5일 네이버 서치어드바이저 웹마스터 가이드를 직접 읽고, 요청 전에 갖출 것과 요청한 뒤 확인하는 방법을 정리했습니다. 서치어드바이저는 네이버가 사이트 운영자에게 주는 검색 관리 도구이고, 그 안의 웹마스터도구에서 수집 요청을 합니다.
1. 네이버 웹페이지 수집 요청이란 무엇인가요?
웹마스터도구가 제공하는 기능으로, 검색로봇이 아직 오지 않은 페이지의 주소(URL)를 사이트 운영자가 직접 넘기는 일입니다. 수집은 검색로봇이 웹페이지를 방문해 내용을 가져가는 일을 말하며 크롤링이라고도 부릅니다.
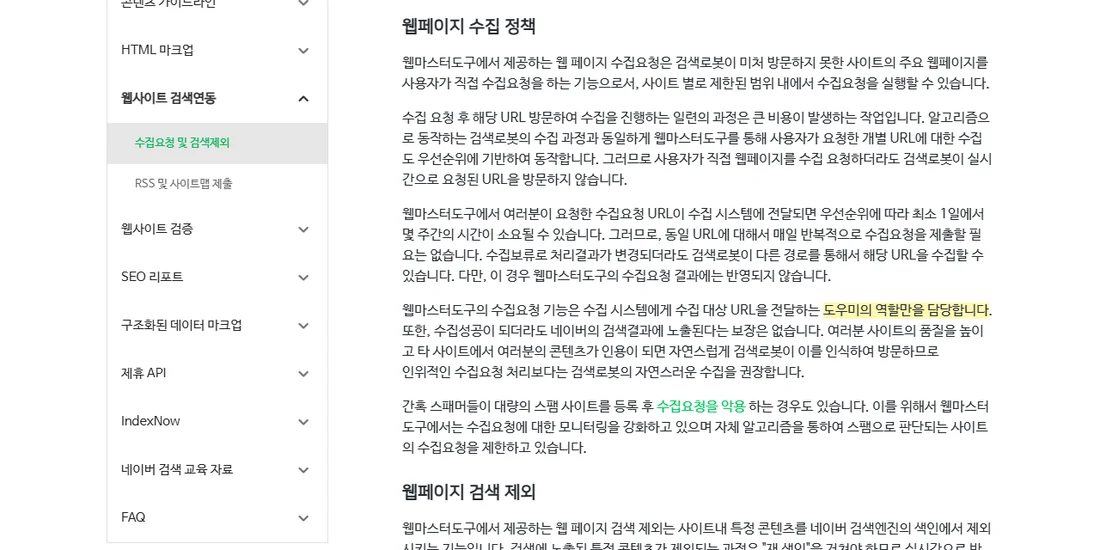
가이드는 사이트 별로 제한된 범위 내에서 수집요청을 실행할 수 있다고 적었습니다. 하루에 몇 건까지인지 같은 숫자는 2026년 11월 5일 가이드 페이지에 없어서, 이 글에도 싣지 않았습니다.
웹마스터도구의 수집요청 기능은 수집 시스템에게 수집 대상 URL을 전달하는 도우미의 역할만을 담당합니다.
가이드는 이어서, 수집에 성공해도 네이버 검색결과에 노출된다는 보장은 없다고 적었습니다. 수집 요청은 주소를 전달하는 일일 뿐이어서, 수집에 성공해도 검색결과에 노출된다는 보장은 없습니다.
2. 요청하기 전에 먼저 확인할 것
수집 요청은 웹마스터도구에 사이트를 등록하고 소유확인을 마친 뒤에 쓰는 기능입니다. 고객센터는 소유확인을 완료하면 웹페이지 수집, RSS 제출, 노출 현황 같은 정보를 함께 볼 수 있다고 안내합니다. 등록 순서는 네이버 서치어드바이저 등록 방법에 정리했습니다.
두 번째는 검색로봇이 막혀 있지 않은지입니다. 가이드는 노출이 안 되는 원인 가운데 하나로, robots.txt(검색로봇에게 수집을 허용하거나 막는 규칙 파일)에서 수집을 허용하지 않은 경우를 들었습니다. 서버 방화벽이 검색로봇을 막는 경우도 같이 적었습니다.
이 두 가지는 가이드가 노출이 안 되는 원인으로 꼽은 것입니다. 규칙 쓰는 법은 robots.txt 설정법에, 소유확인이 막힐 때는 소유확인이 안 될 때에 정리했습니다.
3. 수집 요청 메뉴는 어디에 있나요?
웹마스터도구는 로그인해야 열리는 화면이라 이 글은 실제 도구 화면을 싣지 않았습니다. 수집요청의 정확한 화면 경로는 2026년 11월 5일 공개 가이드에 적혀 있지 않아 확인이 필요합니다.
같은 가이드가 경로를 적은 곳은 검색 제외 기능입니다. 「웹마스터도구 > 사이트 > 요청 > 웹 페이지 검색 제외」로 적었습니다. 수집 요청 메뉴의 이름과 위치는 가이드에 없어 확인이 필요합니다.
robots.txt 파일을 고친 뒤에는 웹마스터도구의 robots.txt 도구에서 「수집 요청」을 눌러 검색로봇에게 빠르게 알릴 수 있다고 가이드가 안내합니다.
4. 요청한 뒤에는 얼마나 걸리나요?
가이드는 요청한 URL이 수집 시스템에 전달되면 우선순위에 따라 최소 1일에서 몇 주간의 시간이 소요될 수 있다고 적었습니다. 사용자가 요청하더라도 검색로봇이 실시간으로 요청된 URL을 방문하지는 않습니다.
같은 주소를 매일 반복해서 수집 요청할 필요는 없습니다. 수집보류로 결과가 바뀌어도 검색로봇이 다른 경로로 그 주소를 수집할 수 있고, 다만 그 경우에는 웹마스터도구의 수집요청 결과에 반영되지 않는다고 가이드는 설명합니다.
구글에서는 같은 일을 색인 생성 요청이라고 부릅니다. 구글 쪽은 구글 서치콘솔 색인 생성 요청하는 법에 있습니다.
5. 수집됐는지는 어떻게 확인하나요?
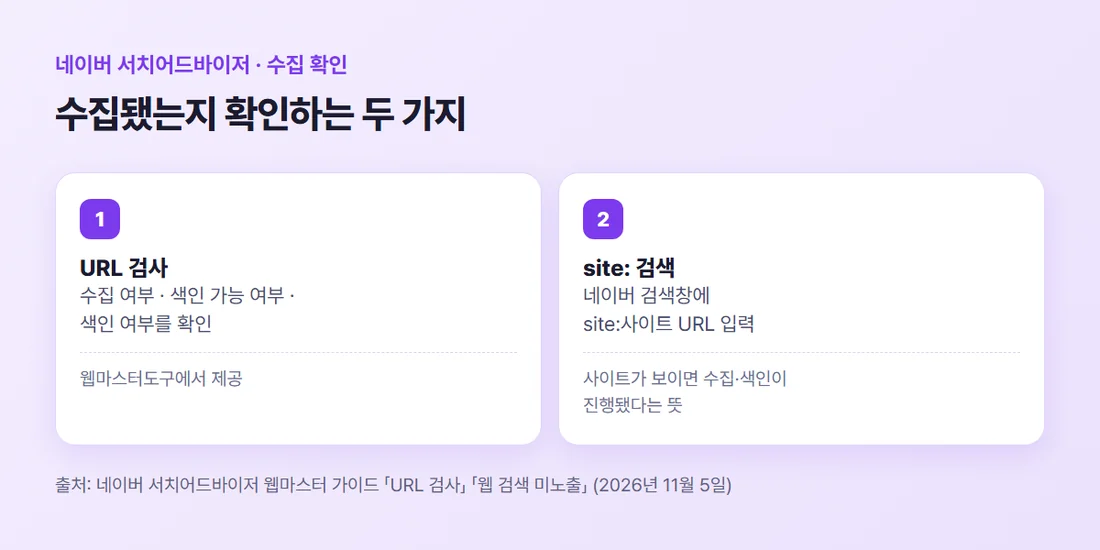
두 길이 있습니다. 하나는 웹마스터도구의 URL 검사입니다. 가이드에 따르면 URL 검사는 URL 상태(StatusCode)와 수집 여부, 색인 가능 여부, 색인 여부를 보여 주어, 내 URL이 수집됐는지와 검색에 노출될 수 있는지를 확인하게 해 줍니다.
다른 하나는 네이버 검색창에 site:사이트 URL 을 넣어 보는 것입니다. 가이드는 사이트가 보이면 네이버가 사이트를 인식하고 페이지를 수집해 색인을 진행했다는 뜻이라고 설명합니다.
보이지 않으면 검색로봇이 아직 수집하지 못했거나, 여러 이유로 수집·색인이 불가능한 문서일 가능성이 있다고 적었습니다. 생성한 지 얼마 안 된 사이트는 네이버가 존재 여부를 아직 모를 수 있다는 설명도 있습니다.
6. 요청보다 자연스러운 수집을 권하는 이유
가이드는 사이트의 품질을 높이고 다른 사이트에서 내 콘텐츠가 인용되면 검색로봇이 자연스럽게 방문하므로, 인위적인 수집요청 처리보다 검색로봇의 자연스러운 수집을 권장한다고 적었습니다.
스패머가 대량의 스팸 사이트를 등록한 뒤 수집요청을 악용하는 경우가 있어, 웹마스터도구가 모니터링을 강화하고 스팸으로 판단되는 사이트의 수집요청을 자체 알고리즘으로 제한한다는 설명도 있습니다.
반대로 이미 지운 페이지를 검색결과에서 빼고 싶다면 수집이 아니라 검색 제외 기능을 씁니다. 가이드 순서는 원본 콘텐츠를 먼저 삭제하고, 삭제된 문서에 검색로봇이 접근할 때 http 응답코드가 404 Not Found 인지 확인한 뒤, 검색 제외 메뉴에 삭제 대상 URL을 입력하는 것입니다.
정리하면 수집 요청은 이렇게 씁니다.
- 웹마스터도구에 사이트를 등록하고 소유확인을 마칩니다
- robots.txt와 방화벽이 검색로봇을 막고 있지 않은지 확인합니다
- 주요 페이지의 URL을 수집 요청합니다. 같은 주소를 매일 다시 요청하지는 않습니다
- URL 검사와
site:검색으로 수집 여부를 확인합니다
색인이 반영되는 시점은 네이버 서치어드바이저 색인, 반영까지 얼마나?에, RSS로 새 글을 알리는 법은 네이버 서치어드바이저 RSS 제출 글에, 전체 그림은 네이버 서치어드바이저란? 처음 쓰는 법 총정리에 있습니다.
참고자료 (모두 2026년 11월 5일 확인)
- 네이버 서치어드바이저 웹마스터 가이드 「수집요청 및 검색제외」 — searchadvisor.naver.com/guide/request-crawl
- 네이버 서치어드바이저 웹마스터 가이드 「URL 검사」 — searchadvisor.naver.com/guide/url-inspection
- 네이버 서치어드바이저 웹마스터 가이드 「웹 검색 미노출」 — searchadvisor.naver.com/guide/faq-serpmissing
- 네이버 서치어드바이저 웹마스터 가이드 「robots.txt 설정하기」 — searchadvisor.naver.com/guide/seo-basic-robots
- 서치어드바이저 고객센터 「소유확인 소개」 — help.naver.com/service/30010/contents/17591
#네이버서치어드바이저 #웹페이지수집요청 #네이버수집요청 #네이버검색등록 #웹마스터도구